Procesamiento de OCR
Permite laprocesar disminucióun archivo con OCR utilizando algoritmos de última generación para detección de pesotexto. oPara tamañoprocesar un documento mediante OCR, es necesario poseer una plantilla previamente configurada para OCR en el panel de archivos tipo imagen mediante el usocontrol de algoritmos avanzados de transformación, modificación y compresión. Todo ello, perdiendo la menor calidad posible.
+Docs.
NOTA: LaEl compresiónprocesamiento de imágenesOCR mediante +Docs puede incurrir en costos adicionales para su balance mensual. Por favor, consulte con su asesor asignado sobre las tarifas y método de pago.
POST: /formularios/docs-plus/image-compressocr
Este servicio no debe consumirse como REST, sino enviando la información como 'form-data'.
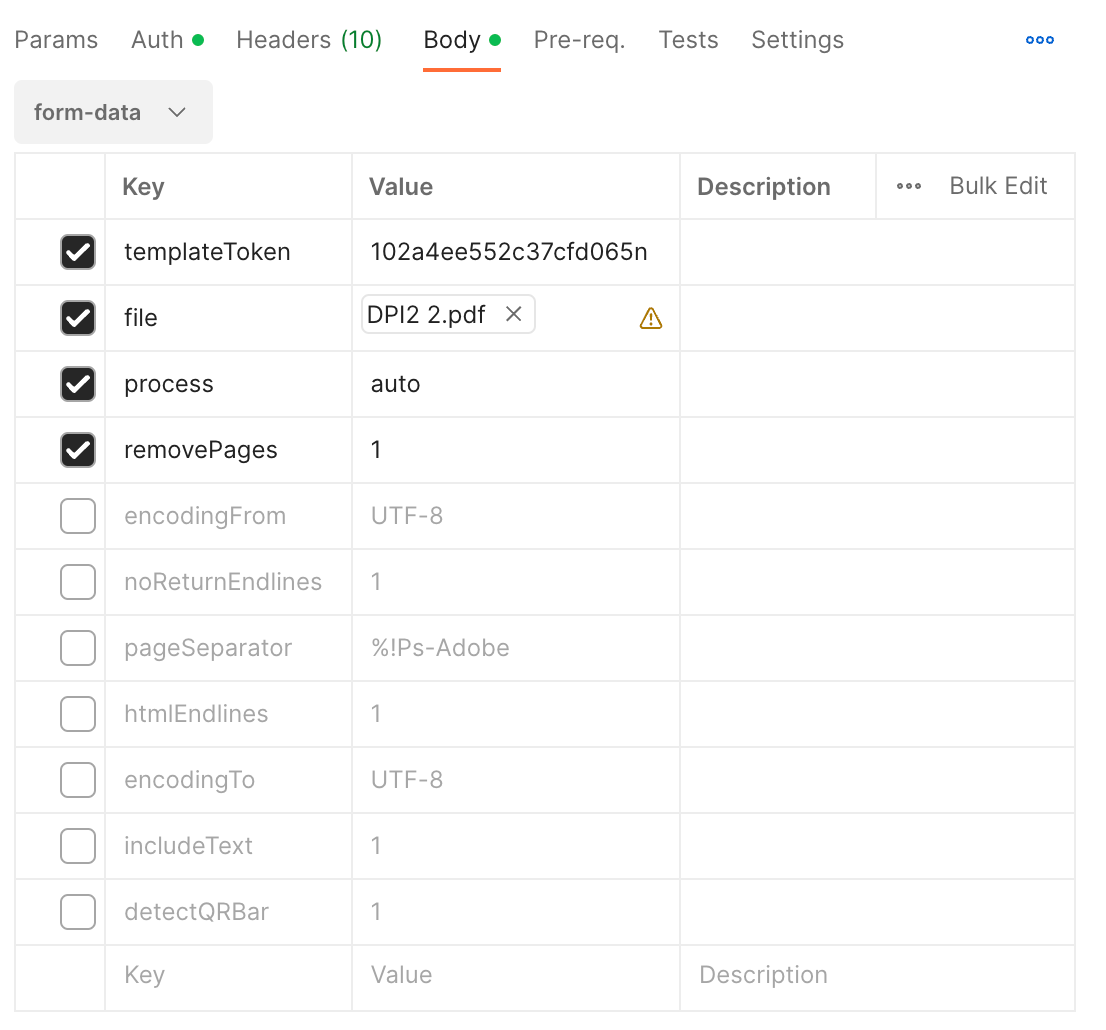
Request (en postman):
Descripción de parámetros
-
filetemplateToken (String)::CampoTokendonderequeridose enviarápara laimagen (emulando campoidentificación detipolaFILE,plantillaHTML)
de OCR configurada en +Docs. -
levelfile (String)File)::NivelRecibedeelcompresión:archivoultralow,quelow,semedium,deseahigh,procesarultra
mediante OCR. -
resizeprocess (String): Permite configurar el tipo de procesamiento, las opciones son las siguientes:-
auto:
Permitepermitecambiarauto detectar eltamañtipo de archivo a procesar. -
image: permite procesar archivos de tipo imagen.
-
text: permite procesar documentos de tipo texto como archivos .txt o con texto plano.
-
pdfText: permite procesar documentos de tipo PDF que sean tipo texto o "buscables".
-
pdfImage: permite procesar documentos de tipo PDF que sean de tipo imagen.
-
-
removePages (int 0,1): permite solicitar al servidor que eliminte las páginas (en caso sea un documento de múltiples páginas) y devuelva un solo listado de variables.
-
encodingFrom (String): en caso el proceso de OCR esté enviando codificaciones incorrectas, permite configurar la codificación de entrada del archivo que estamos enviando, por defecto se intentará determinar automáticamente.
-
encodingTo (String): define la codificación de salida del contenido procesado, por defecto la codificación de salida será UTF-8.
-
pageSeparator (String): permite enviar la configuración de separador de página, para detectar automáticamente un salto de página en archivos de texto plano (sin páginas).
-
includeText (int 0,1): permite solicitar al servidor que devuelva en un parámetro adicional todo el texto encontrado mediante el OCR sin procesar mediante la plantilla. Útil para procesos de prueba y debug.
-
detectQRBar (int 0,1): permite solicitar al servidor que intente reconocer códigos QR que se encuentren en el documento enviado para procesamiento y devolverá el contenido de dicho QR en una variable adicional, esta funcionalidad solo trabajará con process de tipo image o pdfImage. El proceso puede aumentar el tiempo de procesamiento, por lo cual es recomendable no solicitar reconocimiento de QR en caso no sea necesario.
Para ver más información sobre el listado de parámetros diríjase a la sección "Descripción de servicios y parámetros" al inicio de esta guía.
Recomendaciones para un OCR óptimo:
El servicio de OCR funcionará más eficiente enviando el tipo correcto de documento (parámetro process), por lo tanto, se recomienda enviar el tipado correcto o seleccionar la opción "auto".
Fiabilidad de OCR para extracción de tokens:
El porcentaje de fiabilidad del OCR de tipo imagen depende de la imagen, si se recibe una sola medida (ejemplo: 100) se conservará la relación de aspectocalidad de la imagen yo sedocumento cambiarásubido.
-
Para archivos de
tamañotipopor su lado más grande. Si se reciben dos medidas separadas por coma (ejemplo: 100,100) se cambiará su tamaño estirandoimagen oestrechandoPDFlaimagen:imagen(25%-100%) deserextracciónnecesario. -
responsePara(String):archivosPermite seleccionar elde tipodetextorespuestaoquePDFentregará el serviciotexto: (con la imagen comprimida).base64: devolverá la imagen en base 64.binary: devolverá la imagen de forma binaria.
95%-100%)